매 턴, 처음부터
다시 계산한다
코딩 에이전트는 파일 읽기 → 코드 수정 → 테스트 실행을 수십 번 반복합니다. 같은 코드 파일이 매 턴 context에 등장하지만, Serving Layer는 이를 매번 처음부터 prefill합니다.
"코딩 에이전트의 멀티턴 세션에서 중복 코드 블록이 반복 등장함에도 Serving Layer가 매 턴 전체를 prefill하여 불필요한 지연 비용이 발생한다."
소스별 토큰 소비 분포 — 48개 trace
멀티턴 세션의 반복 구조
선행 연구와의 비교
| 방법 | 동적 경계 처리 | 변수명 변화 허용 | RoPE 위치 보정 | 정확도 유지 |
|---|---|---|---|---|
| vLLM prefix caching | ✗ | ✗ | ✗ | ✓ |
| PromptCache | ✗ | ✗ | ✗ | ✓ |
| CacheBlend | ✗ | ✗ | △ 부분 | ✓ |
| SnapKV | — | — | — | ✗ 손실 |
| SynTree KV (본 연구) | ✓ AST 서브트리 | ✓ α-rename | ✓ 완전 보정 | ✓ |
세 가지 핵심 아이디어
기존 prefix caching이 반복 코드를 "다른 것"으로 인식할 때, SynTree KV는 재사용 가능한 구조적 단위로 인식합니다.
AST 서브트리 단위 KV 재사용
Tree-sitter로 실시간 파싱하여 함수·클래스·import 단위를 추출합니다. 깊이 ≥ 2, 토큰 수 ≥ 8인 노드를 색인화하여 재등장 시 즉시 캐시에서 호출합니다.
α-rename 정규화 + BLAKE3 지문
변수명을 VAR_0, VAR_1…으로 치환하여 구조만 남기고 BLAKE3으로 32byte 지문을 생성합니다. 이름이 달라도 구조가 같으면 같은 블록으로 인식합니다.
RoPE Re-positioning
위치가 달라진 KV를 그대로 삽입하면 attention이 왜곡됩니다. 위치 오프셋 Δ를 이용한 회전 행렬 R(Δ)로 보정하여 정확한 재사용을 보장합니다.
# Turn 1에서 등장한 코드
def calc(price, tax):
    total = price * tax
    return total

# Turn 4에서 등장한 코드 — 이름은 다르지만 구조는 동일
def compute(amount, rate):
    result = amount * rate
    return result

# α-rename 적용 → 두 함수 모두 동일한 정규화 결과
def VAR_0(VAR_1, VAR_2):
    VAR_3 = VAR_1 * VAR_2
    return VAR_3

# BLAKE3 해시 → a3f9c2d1... == a3f9c2d1...  →  캐시 히트 ✓
RoPE Re-positioning 보정 수식
재사용 KV는 원래 위치에서 계산된 값입니다. 새 context에서 다른 위치에 삽입될 때 위치 오프셋 Δ를 이용해 Key 벡터를 회전 보정합니다. PromptCache(미처리), CacheBlend(부분)와 달리 완전 보정을 수행합니다.
하드웨어 & 소프트웨어
RTX 5090 × 2가 장착된 ewha-acpl3 서버에서 vLLM과 OpenHands를 연동하여 실험을 수행했습니다.
서버 구성 — ewha-acpl3
hellkitty@acpl3
port 8002 · TP=2
OpenHands — 코딩 에이전트 플랫폼
기술 스택
vLLM 서버 실행 명령
vllm serve ./models/Qwen3-Coder-30B-A3B-FP8 \
  --tool-call-parser qwen3_coder \
  --enable-expert-parallel \
  --tensor-parallel-size 2 \
  --max-model-len 131072 \
  --gpu-memory-utilization 0.9 \
  --port 8002
전체 파이프라인
토큰화부터 LRU eviction까지 단일 흐름으로 처리됩니다.
토큰화 + Tree-sitter 증분 파싱
입력 코드를 실시간 파싱하여 AST를 생성합니다. {FunctionDef, ClassDef, ImportStmt, CallExpr} 노드를 깊이 ≥ 2, 토큰 수 ≥ 8 조건으로 선별합니다.
α-rename → BLAKE3 지문 → SessionCacheTable 조회
서브트리별 fingerprint를 산출하고 캐시 테이블에서 히트 여부를 판단합니다.
적중 (hit) — prefill skip + RoPE-shifted KV splice
prefill 재계산을 생략하고 저장된 KV에 R(Δ) 위치 보정을 적용하여 삽입합니다.
미적중 (miss) — 정상 prefill 후 SessionCacheTable 등록
새로 계산된 KV를 지문을 키로 캐시에 저장합니다.
Decode + 발열 관리
splice된 슬롯을 일반 슬롯과 동일하게 attention에 노출합니다. 32토큰마다 발열 지표를 polling합니다.
턴 종료 — LRU eviction
SessionCacheTable을 512 MB 이내로 유지합니다. 가장 오래된 항목부터 제거합니다.
실험 시연
시연한 실험은 아래 영상에서도 확인할 수 있습니다.
▶ 영상 보기
실험은 EWHA-ACPL3 연구서버(NVIDIA RTX 5090 × 2)에서 진행되었습니다. 외부 네트워크에서 직접 접근할 수 없는 내부 서버 환경 특성상 실제 실행 화면을 순서대로 기록하여 시연합니다.
서버 접속 확인 — GPU 상태 점검
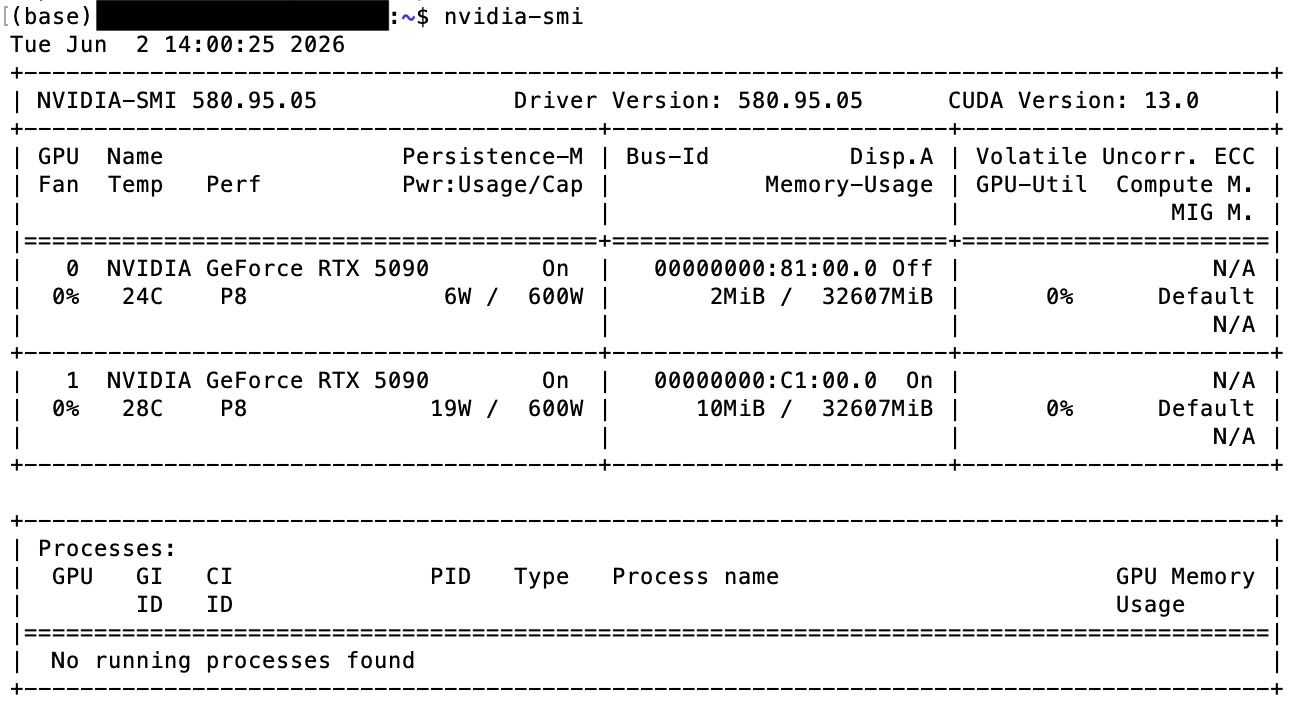
EWHA-ACPL3 서버에 SSH로 접속한 뒤 nvidia-smi로 GPU 상태를 확인합니다.
NVIDIA GeForce RTX 5090 2장이 인식되어 있으며, 실험 전 대기 상태(No running processes)임을 확인합니다.
이후 OpenHands 가상환경을 활성화하고 분석 스크립트를 실행합니다.
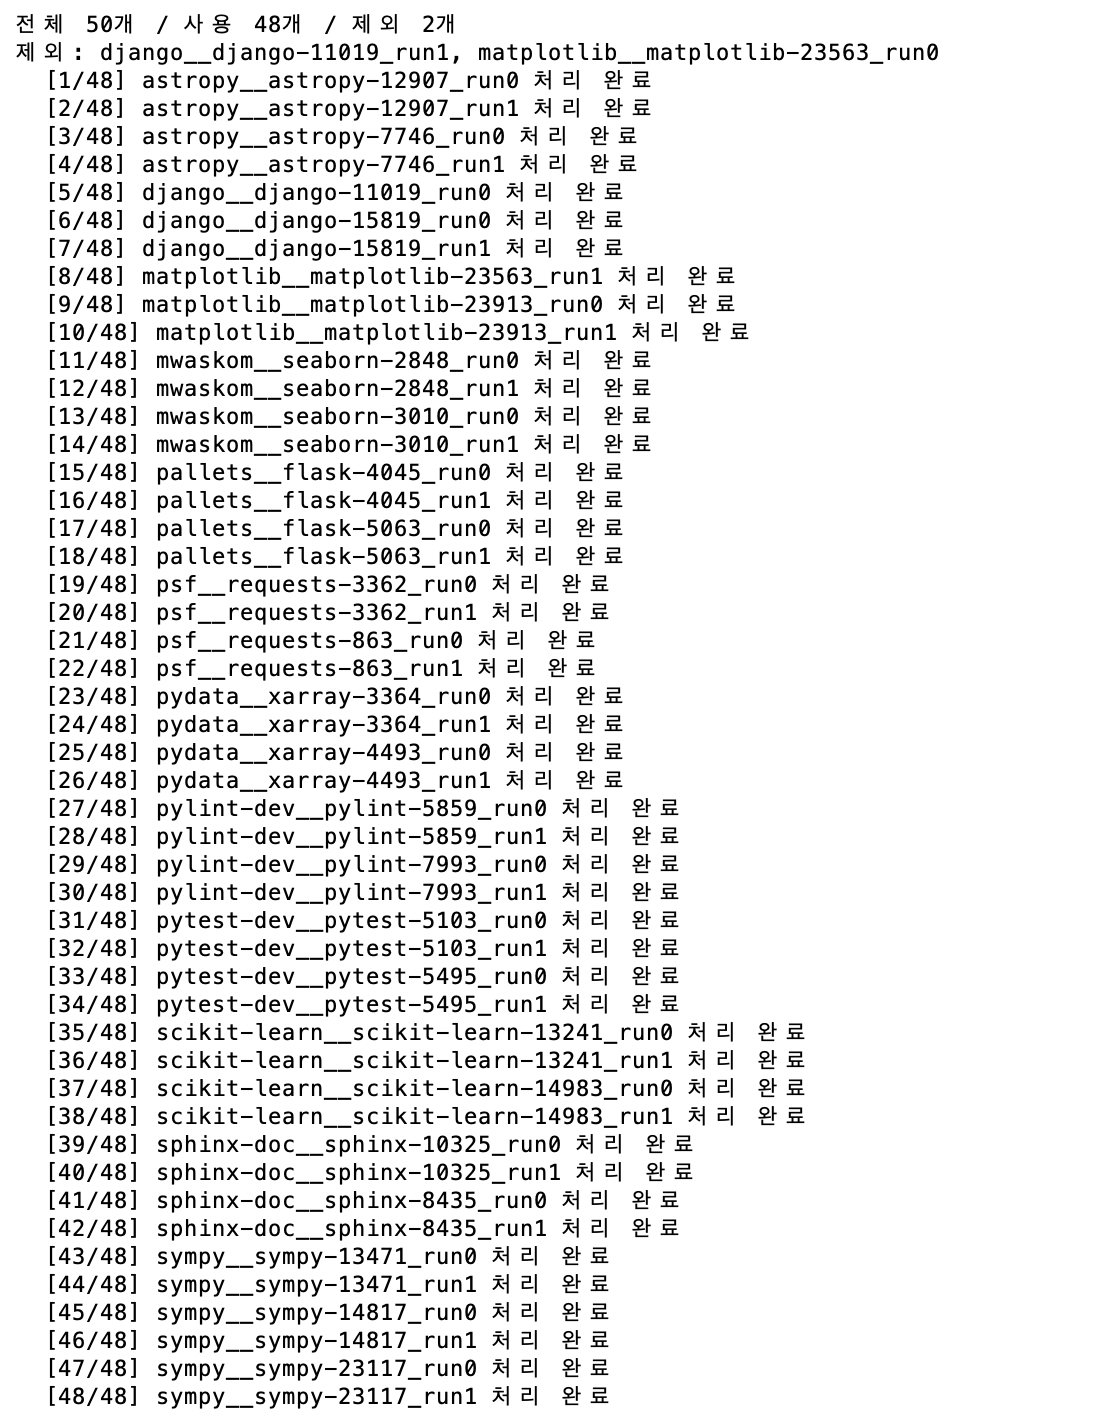
Trace 로딩 — 48개 trace 처리 완료
스크립트가 30b_direct_run01/ 디렉터리를 순회하며 trace를 처리합니다.
전체 50개 중 2개(django-11019_run1, matplotlib-23563_run0)를 제외한
48개 trace가 12개 레포에 걸쳐 균형 있게 처리됩니다.

분석 결과 — 4가지 조건 모두 GO ✓
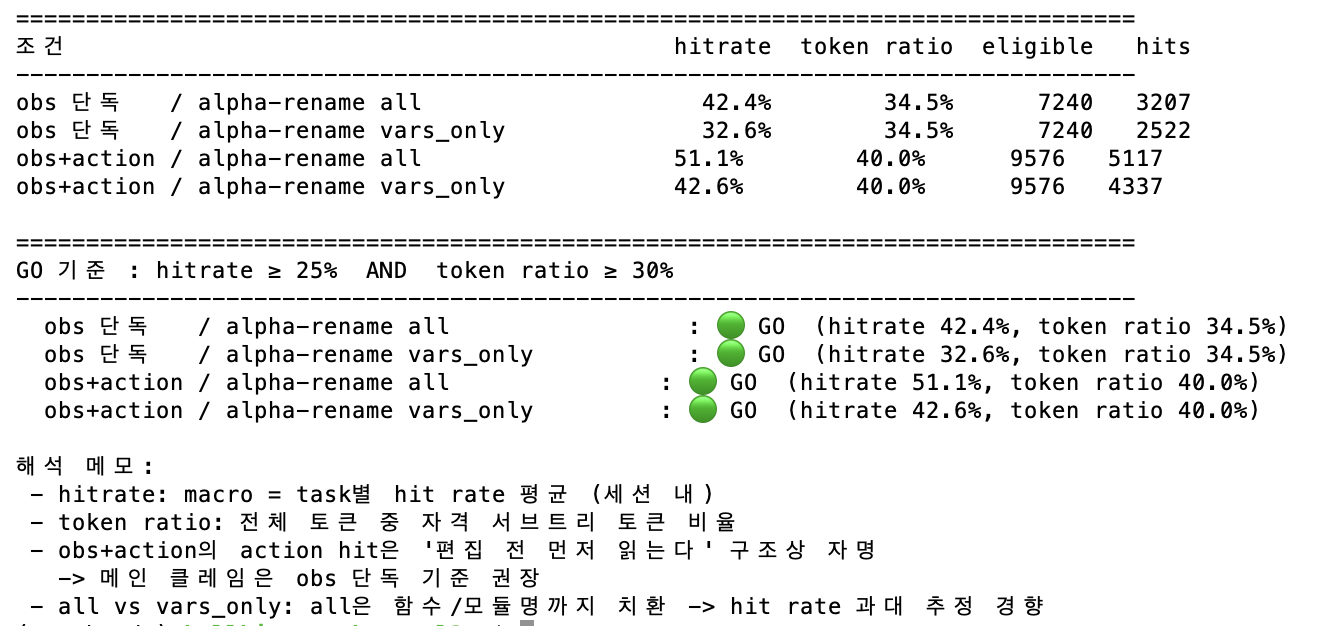
hit rate와 자격 서브트리 토큰 비율(token ratio)을 4가지 조건에서 측정합니다.
조건은 (1) ActionEvent 포함 여부 × (2) α-rename 범위(all vs vars_only)의 조합입니다.
메인 지표는 가장 보수적인 obs 단독 / vars_only 조건으로,
ActionEvent의 자명한 hit을 제외하고 함수명까지 보존한 가장 엄격한 측정값입니다.
이 수치도 GO 기준(hitrate ≥ 25%, token ratio ≥ 30%)을 명확히 초과하여
AST 기반 KV 재사용의 가능성이 데이터로 입증되었습니다.
MVE 실험 결과: GO ✓
48개 trace를 대상으로 hit rate 분석과 TTFT baseline 측정을 수행했습니다. 모든 조건에서 GO 기준을 충족했습니다.
Hit Rate 분석 — GO 기준: hit rate ≥ 25% AND token ratio ≥ 30%
| 조건 | hit rate | token ratio | 판정 |
|---|---|---|---|
| obs / α-rename all | 42.4% |
34.5% | GO |
| obs / vars_only | 32.6% |
34.5% | GO |
| obs+action / all | 51.1% |
40.0% | GO |
| obs+action / vars_only | 42.6% |
40.0% | GO |
목표 효과 — 구현 후 기대 수치
Vanilla vs. vLLM Prefix Caching TTFT 비교
Qwen2.5-Coder-0.5B-Instruct · 48개 trace
실험 그래프 — 전체 trace TTFT 분포

실험 그래프 — 턴별 평균 TTFT 비교

다음 단계
현재까지의 실험이 "재사용할 만한 코드 구조가 충분히 존재하는가"를 확인하는 단계였다면, 앞으로는 실제 KV 재사용 시스템을 구현하고 그 효과를 측정하는 단계로 나아갑니다.
데이터 수집 & 지표 검증
- Trace 수집 및 전처리 (48개)
- AST 지문 파이프라인 구현
- Hit rate 분석 (4가지 조건)
- Vanilla / vLLM prefix caching TTFT baseline 측정
- MVE GO/NO-GO → GO ✓
분석 정밀화 & 핵심 시스템 구현
- Hit rate ↔ TTFT 상관관계 정량 분석
- 태스크별 평균 hit rate 재산출
- SessionCacheTable 구현
- RoPE re-positioning 모듈 구현
최종 성능 검증
- Vanilla / prefix / SynTree KV 3-way TTFT 비교
- HumanEval · MBPP · MultiPL-E 정확도 검증
- 200세션 trace 통계적 유의성 확보
- 최종 TTFT 30% 이상 감축 달성
한계점 및 개선 방향
보정이 완벽하지 않으면 pass@1이 하락할 수 있습니다. YaRN·PoSE 계열 ablation 실험과 Δ가 작은 구간만 허용하는 보수적 정책으로 보완합니다.
AST 서브트리와 vLLM 블록 단위(16~32토큰) 경계 불일치 오버헤드가 발생할 수 있습니다. 패딩 토큰으로 블록 단위에 맞게 정렬하여 해소합니다.
현재 Python에만 적용됩니다. tree-sitter-javascript, tree-sitter-java 등 언어별 문법 파일을 추가하여 다중 언어로 확장할 예정입니다.
Team def(14)
이화여자대학교 컴퓨터공학과 졸업 캡스톤 연구트랙 팀입니다.